
 客户端
 媒体矩阵
 企业邮箱
 工经号


过去两年,大语言模型在办公、写作、客服等场景快速普及。但在工厂、电站、矿山这些真正的工业现场,一项技术能否被采用,标准远比“对话流利”严格:数据能不能出域、答案可不可追溯、系统可不可维护、出错可不可控。通用大模型的能力突飞猛进,能在企业核心业务里稳定运行的应用却仍然有限——这中间的落差,更多是工程问题,而非单纯的算法问题。随着“人工智能+”行动推动大模型走向千行百业,如何让它从“能演示”走到“可靠可用”,成为摆在产业面前的现实课题。如今,在国家能源集团担任首席AI大模型架构师的周佺喜,做的正是这件事:把大模型放进复杂业务系统,让它经受安全、数据与可靠性的工业级约束。
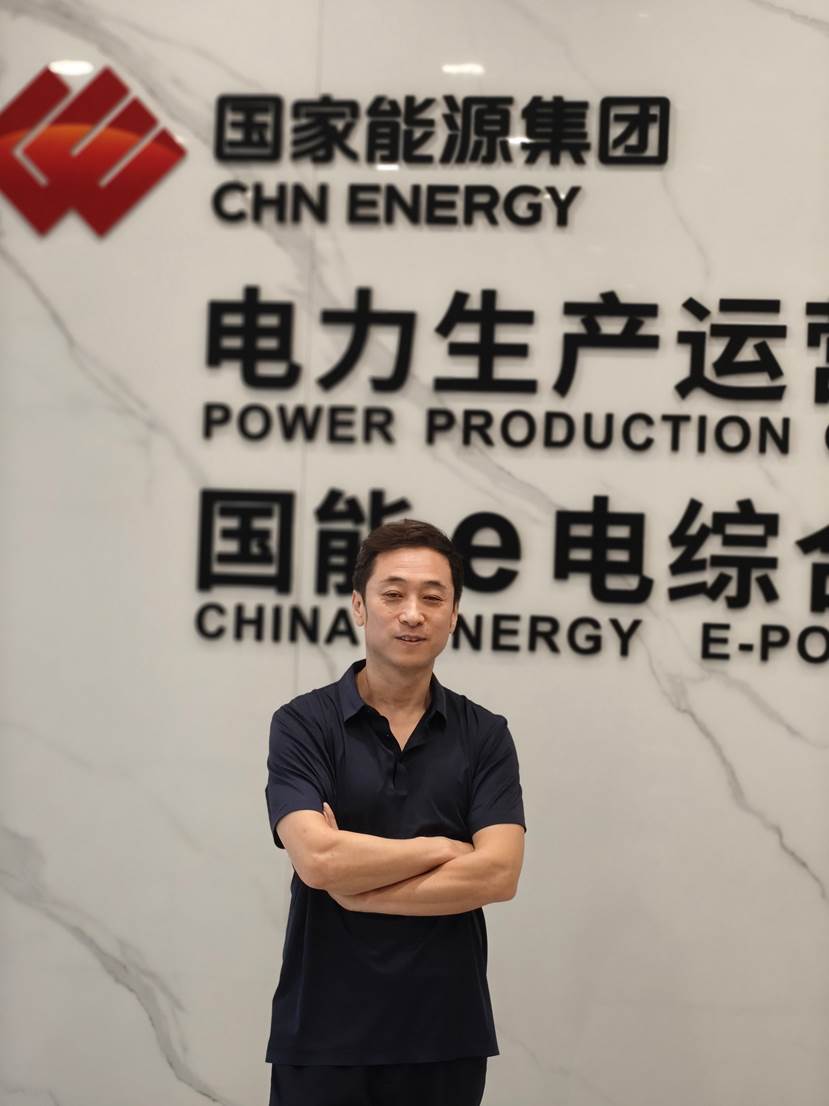
周佺喜作为一名在软件研发一线工作多年的“老工程师”。2009年,他围绕网页即时通讯中实时显示网站用户状态的方法申请了发明专利,并于2012年获得授权,较早开展了对网络通信技术的探索。与许多从算法研究转入产业的同行不同,他的技术底色是供应工程。在英国攻读硕士期间,他接受的训练,是把由人、设备、流程、信息构成的复杂系统当作一个整体来设计——任何环节的优化,都要回答成本、风险与全生命周期的问题。此后,他紧跟时代潮流通过不断地学习和努力,把这套系统视角带进了大模型领域。“模型能力是起点,不是终点。”他这样概括自己的立场,“在企业里,孤立的模型演示没有意义,有意义的是它能不能嵌进业务流程,被治理、被运维、被持续改进。”
在周佺喜看来,企业级大模型落地的难点,恰恰不全在模型本身。“从演示到生产,中间隔着的全是工程。”他说。第一道关是数据治理:企业知识分散在文档、工单、报表和老师傅的经验里,格式不一、权限各异,还涉及敏感信息,“喂给模型之前,先要回答数据从哪里来、能不能用、谁可以看到答案”。第二道关是系统集成:大模型要与既有的业务系统、身份体系、审批流程打通,而不是另起炉灶。第三道关是可靠性:工业场景容错率低,回答必须可追溯、可验证。为此,他把检索增强生成(RAG)作为连接通用模型与企业知识的主要方法,让模型“有据可依”,而不是凭参数记忆“自由发挥”;面对更复杂的任务,他则诉诸多智能体协同——单个智能体“包打天下”很快会撞上能力与上下文的极限,让多个智能体各司其职,通过任务规划与协商完成单次对话无法完成的工作,再以协议和工程手段约束它们的行为边界。能源行业为这套方法提供了严苛的试炼场:安全要求高、业务链条长、数据高度敏感,任何架构选择都要经受工程纪律的检验。
长期一线工作让周佺喜意识到,工业AI缺的不是热度,而是可复用的工程方法。2025年9月,他在机械工业出版社出版《快速掌握大模型应用开发:写给AI时代程序员的技术指南》(以笔名“周泉玺”署名),系统讲解大模型应用架构、提示词工程、RAG、智能体开发与量化部署,并配套实战案例源码,面向程序员和企业开发者。此后,他又在电子工业出版社出版《多智能体协同:基于大语言模型的工程实践与系统构建》,以原理、方法、应用、保障为主线,围绕多智能体协同、MCP与A2A等协议、任务规划、协商决策与工程化保障展开。在碎片化的网络教程与偏重理论的学术著作之间,一线开发者需要成体系、可直接上手的工程读本,这正是两本书的定位:把散落在项目里的经验,整理成别人可以照着做的路径。“写书的动力很朴素,”他说,“一个行业要成熟,经验就必须能传递下去,而不是停留在少数人脑子里。”
采访中,周佺喜反复提到“长期”二字。在他看来,工业AI不会有一夜之间的颠覆,只有一个个系统、一份份文档、一次次验收的积累。“大模型给了我们新的工具,但工业的价值标准没有变——稳定、安全、可维护。工程师的职责,是让新技术在这个标准之下真正站住脚。”他说。当越来越多的行业开始把大模型当作基础设施来建设,比灵感更稀缺的,正是这种把工程纪律与AI能力结合起来的耐心,以及把个人经验沉淀为行业方法的自觉。(王禹)